Koliko RAM-a potrebuje prenosnik za lokalni zagon UI-ja?
Datoteka qwen3.5:4b-q4_K_M (LLM, velik jezikovni model), velika 3,4 GB, lahko že nocoj odgovarja na vprašanja na povsem običajnem prenosniku s 16 GB pomnilnika, brez računa v oblaku. Preneseš jo z Ollamo, zastaviš eno vprašanje v 4K kontekstu in že lokalno poganjaš pravi UI-model, na strojni opremi, ki jo že imaš. Model bere besedilo in slike, pri tem pa gre za sklepanje, ne učenje: modela tu nihče ne uči ničesar novega, samo odgovarja.
Nejasna nalepka »AI PC« na škatli prenosnika ni tehnična specifikacija. To so RAM, pomnilnik, ki ga lahko uporablja GPU, shramba in programska podpora. 16 GB pomnilnika je prava vstopna točka za manjše UI-modele, ni pa ne prenizek minimum, ki ga lahko kar odpišeš, ne obljuba za vse, kar oglašuje specifikacijski list. Več pomnilnika pomeni več konteksta in več prostora za večopravilnost. S 16 GB lahko začneš.
Kaj pri poganjanju UI-ja na prenosniku uporablja RAM
Velikost prenosa modela in količina RAM-a, ki jo model porabi med delovanjem, sta dve različni številki. Prav njuno mešanje je najpogostejša napaka pri izbiri prenosnika za UI. Tistih 3,4 GB, ki jih preneseš za qwen3.5:4b-q4_K_M, je datoteka na disku. Za nalaganje pa potrebuješ pravi pomnilnik. Prav tako ga potrebuje kontekstno okno, torej tekoči pogovor, ki ga model med odgovarjanjem ohranja v pomnilniku, tako imenovani KV-predpomnilnik. Pomnilnik porabi tudi samo pogonsko okolje, poleg tega pa še vse, kar že uporabljata operacijski sistem in druge aplikacije.
Ollama privzeto naloži kontekst s 4.096 žetoni, to mejo pa lahko povečaš. Če hkrati izvajaš več zahtevkov, se potreba po pomnilniku za kontekst približno pomnoži s številom vzporednih zahtevkov. Specifikacije modela lahko navajajo kontekstno okno s 128K ali 256K žetoni, vendar to vzemi kot zgornjo mejo modela, ne kot obljubo, da lahko tvoj prenosnik s 16 GB vse to hkrati uporablja brez težav.
RAM, VRAM in enotni pomnilnik niso isti bazen
Čipi Apple Silicon uporabljajo enotni pomnilnik: CPU in GPU črpata iz istega sklopa 16, 24 ali 32 GB, zato ti ne more zmanjkati ločenega grafičnega pomnilnika. Običajen prenosnik z Windows ali Linuxom in namenskim grafičnim procesorjem NVIDIA deluje drugače. Sistemski RAM in lastni VRAM grafičnega procesorja sta dva ločena sklopa, zato 16 GB sistemskega RAM-a in 8 GB pri GPU-ju ne pomenita enotnega sklopa 24 GB, ki bi ga model lahko prosto uporabljal.
Ko model v celoti ne gre v GPU, del naloge prevzame CPU. Temu rečemo delni prenos obremenitve, zato je model sicer mogoče naložiti, vendar deluje opazno počasneje. Če zaženeš , ti ukaz natančno pokaže razdelitev med CPU in GPU za vse, kar je trenutno naloženo.
Kapaciteta je le polovica zgodbe. Enako pomembno je, kako hitro se ta pomnilnik pretaka: Apple za MacBook Air M5 navaja 153 GB/s pomnilniške prepustnosti. Prav prepustnost, ne le velikost pomnilnika, pomembno prispeva k temu, da je enotni pomnilnik odziven in ne le tehnično zadosten.
Kvantizacija: kako se UI-model z 9B skrči, da gre v RAM
Kvantizacija je razlog, da je ta prenos velik le 3,4 GB: uteži modela se shranijo z nižjo številčno natančnostjo, zato je datoteka manjša. Razpon pri Qwen3.5 in njegovem modelu 9B to lepo pokaže. Isti model 9B se prenese kot 6,6 GB v različici Q4_K_M, 11 GB kot Q8_0 in 19 GB pri polni natančnosti BF16. Isti model, isto število parametrov, tri zelo različne velikosti prenosa, in spet gre za velikost datoteke za prenos, ne za RAM, ki ga model potrebuje med delovanjem.
Nižja natančnost praviloma nekoliko vpliva na kakovost, koliko pa, je odvisno od naloge in ne od nekega fiksnega odstotka. Preden izbereš Qwen kot svoj prvi model, je dobro vedeti še eno praktično posebnost: nekateri uporabniki poročajo, da njegov korak »thinking« opazno podaljša čakanje, preden se prikaže odgovor, v primerjavi z modeli, ki odgovorijo bolj neposredno. Zato se splača oba pristopa preizkusiti pri svojih nalogah, namesto da bi vnaprej predpostavil, da je eden preprosto boljši.
Imaš že MacBook s 16 GB? To preizkusi, preden karkoli kupiš
Če že imaš MacBook s 16 GB, začni z modelom 2–4B pri natančnosti Q4 in s 4K kontekstom, preden sploh razmišljaš o nakupu. Naloži se lahko tudi model 9B Q4 ali kaj v slogu Gemma 4 12B QAT. Ali bo to res delovalo, je odvisno od tega, koliko drugih aplikacij imaš odprtih, koliko konteksta uporabljaš in kako obremenjen je prenosnik v tem trenutku, zato to vzemi kot možnost, ki jo je vredno preizkusiti, ne kot jamstvo.
Kupuješ prav za to uporabo? MacBook Air 13-inch with M5 chip je standardno opremljen s 16 GB enotnega pomnilnika, nastaviti pa ga je mogoče do 32 GB. In še preden te zamika večji zaslon kot nadgradnja: 15-palčni M5 Air se prav tako začne pri enakih možnostih 16, 24 in 32 GB pomnilnika ter pri isti prepustnosti 153 GB/s kot 13-palčna različica. Velikost zaslona izberi zaradi udobja, ne zato, ker bi s tem dobil več prostora za UI. Tega ne dobiš.

Imaš že prenosnik z Windows ali Linuxom in 16 GB? Začni tukaj
Tudi prenosnik z Windows ali Linuxom s 16 GB, brez namenskega GPU-ja, lahko poganja manjši model. Ollama deluje neposredno v Windows, zato najprej prenesi model 2–4B Q4 in ga preizkusi na CPU-ju ali integrirani grafiki, preden karkoli zapraviš. Pri občutku delovanja pričakuj več razlik kot pri Apple Siliconu: ene same številke žetonov na sekundo ni mogoče posplošiti na vse naprave, saj nihče ni izmeril vsake posamezne konfiguracije.
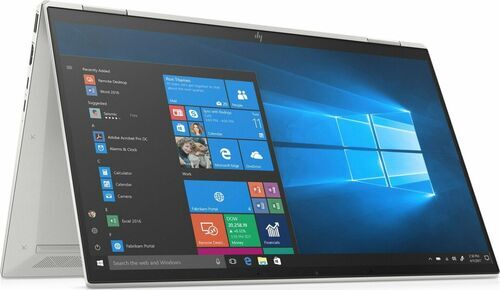
Lenovo ThinkPad T14 G2 in HP EliteBook x360 1040 G7 imata oba 16 GB RAM-a in integrirano grafiko, torej sodita natanko v ta razred naprav. Predvsem pri starejšem obnovljenem prenosniku, kot sta ta dva, je smiselno najprej preveriti še eno stvar: LM Studio v Windows x64 zahteva podporo za AVX2, tega nabora ukazov pa nimajo vsi starejši procesorji. Zato preveri, ali ga tvoj konkretni procesor podpira, preden predpostaviš, da bo katerikoli prenosnik v tem razredu brez težav poganjal izbrano orodje.
Past poimenovanja GPU-jev v prenosnikih: zakaj »RTX 5070 Ti« ni ena sama številka
Prenosniški GPU-ji NVIDIA imajo enaka imena kot namizne kartice, vendar ti to ime pove manj, kot bi pričakoval. RTX 5060 Laptop GPU ima 8 GB pomnilnika GDDR7 in objavljen razpon porabe od 45 do 100 vatov. RTX 5070 Ti Laptop GPU ima 12 GB GDDR7 in od 60 do 115 vatov. Rezultat za namizni RTX 5070 Ti, ki ga najdeš na spletu, ni rezultat za prenosniški RTX 5070 Ti, ne glede na to, kaj nakazuje ime.
V istem imenu se skriva še druga past. Dva prenosnika imata lahko oba »RTX 5070 Ti Laptop GPU«, pa se vseeno pri dolgotrajnejši obremenitvi obnašata različno: tanjše in lažje ohišje upravlja toploto drugače kot debelejše in težje, zato isto ime GPU-ja ne zagotavlja enake dejanske hitrosti, ko ventilatorji že nekaj časa delujejo. Vedno preveri točno količino VRAM-a in konkretno napajalno nastavitev prenosnika, ne le imena družine GPU-jev.
Kupuješ Mac za to nalogo? Udobnejši razred z enotnim pomnilnikom
Če kupuješ predvsem zato, da boš lokalni UI uporabljal redno, je pri Applu udobnejša izbira 24 do 32 GB enotnega pomnilnika: tako dobiš dovolj prostora za večji model, daljši kontekst ali preprosto za to, da imaš med delom odprte še druge aplikacije. Če pričakuješ, da boš to uporabljal pogosto, in ti proračun to dopušča, izberi 32 GB.
MacBook Pro 13-inch with M2 chip je dober primer obnovljene naprave, ki je že nad vstopnim razredom 16 GB: njegov 8-jedrni CPU in 10-jedrni GPU je mogoče kombinirati z do 24 GB enotnega pomnilnika. Gre za starejšo generacijo čipa kot pri M5 Airu, zato tukaj pričakuj zgornjo mejo 24 GB, ne pa ločenih možnosti 24/32 GB, ki jih ponuja M5 Air.
Kupuješ Windows ali Linux? Išči namenski GPU
Če nov prenosnik kupuješ predvsem za lokalni UI, išči 32 GB sistemskega RAM-a skupaj z namenskim prenosniškim GPU-jem NVIDIA z vsaj 8 GB lastnega VRAM-a, oziroma 12 GB, če ti ustreza nekoliko težji ali dražji prenosnik. 8 GB je lahko realen cilj za modele 4–7B pri natančnosti Q4 in zmernem kontekstu, vendar tega ne jemlji kot samoumevne rezerve: že prenos 9B Q4, velik 6,6 GB, lahko za udobno delovanje potrebuje več kot zgolj osnovnih 8 GB, 12 GB pa preprosto omogoča lažje preizkušanje v tem razredu.
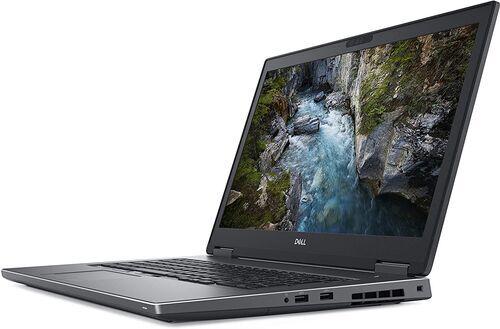
Dell Precision 7730 je dober obnovljen primer te osnovne zamisli, tudi če ne uporablja povsem enakih novih čipov kot zgornji primeri: 32 GB sistemskega pomnilnika dopolnjuje namenski NVIDIA Quadro P3200 s svojimi 6 GB VRAM-a. To je druga generacija in drug razred GPU-ja kot današnja RTX 5060 in 5070 Ti Laptop GPU, vendar temelji na istem načelu ločenih pomnilniških sklopov.

Zanimiva alternativa: AMD-jevi prenosniški čipi z veliko pomnilnika
Procesor AMD Ryzen AI Max+ 395 podpira do 128 GB sistemskega pomnilnika LPDDR5x, odvisno od konkretne konfiguracije prenosnika. To je drugačna pomnilniška zasnova, ki jo je dobro poznati, vendar ima tudi pomembno omejitev: na seznamu podpore Ollama za ROCm v Linuxu je ta čip naveden, na trenutnem seznamu ROCm za Windows pa ga ni.
To ni razlog, da bi čip kar odpisal, ampak razlog, da pred priporočilom za konkreten prenosnik preveriš natančno količino vgrajenega pomnilnika, operacijski sistem, GPU-zaledje, gonilnike in vedenje Ollame. Prenosnik AMD z veliko pomnilnika zato obravnavaj kot zanimivo alternativno zasnovo, ki jo je vredno skrbno raziskati, ne pa kot privzeti prvi nakup za nekoga, ki se z lokalnim zagonom UI-ja šele spoznava.
Programska plast: Ollama in LM Studio brez zapletanja
Ollama je najpreprostejši način, da model pripraviš do pogovora na svoji napravi: preneseš model, ga zaženeš in že imaš lokalni strežnik, ki odgovarja na zahteve, brez računa v oblaku za preneseni model. Prav to orodje stoji za vsemi primeri tukaj.
LM Studio ponuja grafično alternativo s svojim brskalnikom po modelih in klepetalnim oknom. Objavlja tudi svoje minimalne zahteve: najmanj 16 GB RAM-a na Macu ali Windows, obvezna podpora AVX2 v Windows x64 in priporočeni 4 GB namenskega VRAM-a v Windows. Pravilna nastavitev kateregakoli od teh orodij je tema zase.
Še opozorilo, preden zaupaš eni sami številki hitrosti, ki jo prebereš na spletu: uradno orodje llama-bench loči hitrost obdelave poziva od hitrosti generiranja ter poroča o razlikah med ponovljenimi preizkusi, ne le o eni sami številki. Objava na forumu z navedbo ene vrednosti žetonov na sekundo redko pove, katero od obeh meritev je avtor sploh meril ali kolikokrat jo je ponovil.
Kontrolni seznam za nakup ali nadgradnjo prenosnika za UI
Preden kupiš ali nadgradiš prenosnik posebej za lokalni UI, preveri konkretne podatke, ne marketinga.
Točen model GPU-ja in količina VRAM-a. Ne le ime družine GPU-jev, ampak točna različica prenosnika in njena količina pomnilnika, saj lahko isto ime skriva različne količine VRAM-a.
Spajkan ali nadgradljiv RAM. Pri nekaterih prenosnikih lahko pomnilnik pozneje dodaš, pri številnih sodobnih tankih in lahkih modelih pa ne. Dobro je vedeti, kaj pravzaprav kupuješ.
Prost prostor na SSD-ju. Prenosi modelov segajo od manj kot enega gigabajta do precej več kot desetih, rastoča zbirka pa se hitro nabere poleg vseh tvojih drugih datotek.
Toplotno obnašanje pri daljši obremenitvi. Eno vprašanje modelu in več zaporednih zahtevkov na prenosniku nista isti preizkus; hrup ventilatorjev in znižanje zmogljivosti po več pozivih povesta več kot ena hitra demonstracija.
Podpora operacijskega sistema in gonilnikov. Preveri, ali ima tvoja točna kombinacija GPU-zaledja in operacijskega sistema podporo za Ollamo ali LM Studio, preden to vzameš za samoumevno.
Številka TOPS za NPU na škatli ni jamstvo za prepustnost. To je marketinški podatek, ne preizkušen rezultat iz pogona, ki ga boš uporabljal. Nejasna oznaka »AI PC« ne more nadomestiti nobenega od zgornjih preverjanj.
Pet obnovljenih prenosnikov, ki te razrede že pokrijejo

Pogosta vprašanja o poganjanju UI-ja na prenosniku
Ali za lokalni zagon UI-ja potrebujem namenski GPU?
Ne. Manjši model lahko na številnih prenosnikih s 16 GB deluje na CPU-ju ali integrirani grafiki, le da bo hitrost bolj nihala kot pri prenosniku z namenskim GPU-jem. Začni z modelom 2–4B, preden sploh predpostaviš, da potrebuješ namensko grafiko.
Ali bo 8 GB RAM-a dovolj?
Ne dovolj udobno za modele, obravnavane tukaj. 16 GB je realna začetna točka, ko upoštevaš, da si model, njegovo kontekstno okno, pogonsko okolje in operacijski sistem delijo isti pomnilnik.
Ali je lokalni zagon modela isto kot njegovo učenje?
Ne. Vse zgoraj opisano je sklepanje: že izurjenemu modelu postavljaš vprašanja. Učenje pomeni gradnjo modela od začetka in zahteva precej zmogljivejšo strojno opremo, kot jo ima katerikoli tukaj omenjeni prenosnik.
Ali več RAM-a zagotavlja hitrejše odgovore?
Ne. Več pomnilnika pomeni več rezerve za večje modele, daljši kontekst in več odprtih aplikacij, dejanska hitrost pa je odvisna od pomnilniške prepustnosti, GPU-zaledja in konkretnega modela, ne samo od količine pomnilnika.
Ali so moji podatki zasebni, ko model teče lokalno?
Da, v smislu, da tvoji pozivi ostanejo na tvoji napravi in ne odidejo k ponudniku v oblaku. Ollama se privzeto veže na tvoj prenosnik in zahtevkov ne pošilja nikamor drugam, razen če namenoma nastaviš dostop do oblaka.
Preizkusi še danes, potem kupuj bolj samozavestno
Že imaš prenosnik s 16 GB? Že nocoj namesti Ollamo in zaženi en manjši model, preden zapraviš en sam cent za kaj novega. Kupuješ prav za to? Za izhodiščno primerjavo vzemi zgornji kontrolni seznam in pet pravkar predstavljenih obnovljenih prenosnikov, ne marketinškega lista s specifikacijami.
Vsak prenosnik na refurbed je pred objavo preizkušen in razvrščen po stanju, zato dobiš točno tak RAM in konfiguracijo, kot ju kupiš. Naslednji vodič v tej seriji pokaže, kako svojo prvo aplikacijo povežeš z modelom, ki si ga pravkar preizkusil.


Prvič se prijavite na naše novice in prihranite 15 €!
Nikoli več ne zamudite ponudbe.
Informacije o uporabi osebnih podatkov najdete v naši Politiki zasebnosti.
Pridobi aplikacijo refurbed
Za iOS in Android


Potrdi registracijo
Skoraj končano: Poslali smo vam potrditveno e-sporočilo.
- © Refurbed Marketplace GmbH
- Dostopnost
- Pogoji in določila
- Pravilnik o zasebnosti
- Impresum
- Pravna obvestila
- European Data Act
- Cookie Policy